Yapay Sinir Ağları Nedir

Yapay Sinir Ağları Hakkında özet bilgiler

Fann Nedir

Fast Artifical Neural Networks Kütüphanesi hakkında

FannTool

Nedir Ne işe yarar Nasıl Kullanırız

What are Artificial Neural Networks ?

short info about Artificial Neural Networks

What is FANN ?

about Fast Artifical Neural Networks library

FannTool

What is and How to use

Yapay Sinir Ağları etiketine sahip kayıtlar gösteriliyor. Tüm kayıtları göster

23 Haziran 2015 Salı

YSA ile Maç Sonucu Tahmini

YSA ile Maç Sonucu Tahmini


Bu çalışmada FannTool kullanarak Futbol Maçları için sonuç tahmini yapan YSA modelinin dizayn edip eğitim ve test aşamaları adım adım açıklanmış, sonuçlar değerlendirilmiştir. Öncelikle dizayn edeceğimiz YSA modeli için problemi tanımlayalım. Futbol maçlarının olası 3 sonucu vardır; Galibiyet Beraberlik Mağlubiyet. Girdi olarak Ev Sahibi ve Misafir takıma ait sezon boyunca oynadığı maçlar sonucunda çıkan 9 farklı performans kriteri kullanılacaktır. YSA dan beklenen eğitim sonunda soru olarak verilen Ev Sahibi ve Misafir Takım performansları için muhtemel maç sonucunu hesaplamak.

....

 Her ne kadar Futbol maçları sonuçlarını yüksek doğrulukla tahmin edemesek te Yapay Sinir Ağlarının, FANN kütüphanesinin, FanntTool yazılımının her alanda nasıl kullanılabileceğine örnek olabilecek bir çalışma yapmış olduk.

KARAR DESTEK SİSTEMLERİ DERSİ
FİNAL ÖDEVİ
YAPAY SİNİR AĞLARI UYGULAMASI
 İdris AKBIYIK

Download ;

17 Ekim 2014 Cuma

Artificial Neural Network Approach to Mobile Robot Localization

Artificial Neural Network Approach to Mobile Robot Localization
David Swords
Aalto University / School of Electrical Engineering
Department of Automation and Systems Technology
Thesis submitted in partial fulfillment of the requirements for the degree of
Master of Science in Technology

In the robotics community, localization is considered a solved problem, however, the topic is still open to investigation. Mobile robot localization has been focused on developing low-cost approaches and there has been great success using probabilistic methods. Parallel to this, and to a much lesser extent, artificial neural networks (ANNs) have been applied to the problem area with varying success.


A system is proposed in this thesis where the typical probabilistic approach is replaced with one based purely on ANNs. This type of localization attempts to harness the simplicity, scalability and adaptability that ANNs are known for. The ANN approach allows for the encapsulation of a number of steps and elements well known in a probabilistic approach, resulting in the elimination of an internal explicit map, providing pose estimate on network output and network update at runtime.

First, a coordinate-based approach to localization is explored: 1D and 2D trained maps with pose estimates. Second, the coordinate-based approach is eliminated in an effort to replicate a more biologically inspired localization. Finally, a path-finding algorithm applying the new localizaiton approach is presented
....
The FANN library (FANN) provides tools implementing, designing, visualizing
and simulating ANNs.
...
FANN provides many commandline functions and visualization tools for creating,
training and simulating ANNs. With the availablity of visualization tools,
like FANNTool, make it much easier to deveop ANNs and applying them to
common tasks like curve fitting, pattern recognition, and clustering.
...
FANNTool is a GUI to the FANN library which allows ease of use without the
need to program the function calls necessary to perform simple tasks. FANNTool
is an open source project, supported by a community of FANN users.

1 Aralık 2013 Pazar

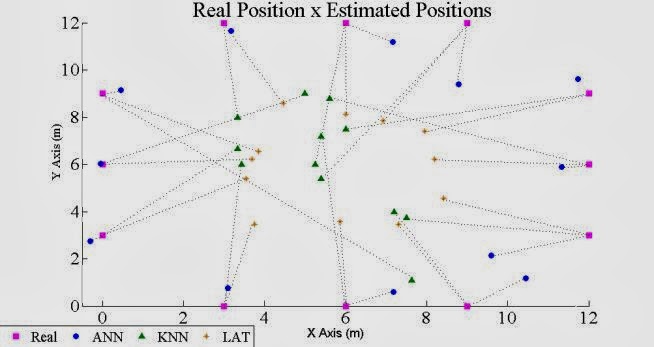
Performance Evaluation of Lateration, KNN and Artificial Neural Networks Techniques Applied to Real Indoor Localization in WSN


Leomário Machado, Mauro Larrat and Dionne Monteiro
Research Group on Computer Networks and Multimedia Communication
Federal University of Para – UFPA
Belém/PA - Brazil

Abstract-In Wireless Sensor Networks, several protocols and algorithms seek to prolong the network lifetime; among them, the localization algorithms are used as an accessory to provide the smallest distances for sending messages. This paper compares the Lateration, KNN and ANN as localization techniques to estimate planar coordinates using the RSSI in an indoor environment using a real WSN based on IRIS motes. The results show that a well worked out ANN is superior to Lateration and KNN.


Our application of ANN used for the localization of nodes in WSN is accomplished through the acquisition of RSSI from the messages sent from each node. Subsequently, these data are used to train and validate the network. For each location point, the mean and standard deviation are calculated to identify the 10% worst samples. With this, only accurate samples are used to train the ANN. To train the ANN, the collected points (x, y) are normalized maintaining those data output values between 0 and 1. To define the architecture of the ANN, several tests are done to achieve a satisfactory configuration of the ANN, i.e., number of hidden layers, number of neurons in each layer, activation function for each layer or neuron and training algorithm.

7 Kasım 2013 Perşembe

ESTIMATIVE OF ULTRAVIOLET SOLAR RADIATION IN BOTUCATU/SP/BRAZIL UTILIZING MACHINE LEARNING TECNICS.


Botucatu, 2013. XXXp. Dissertação (Mestrado em Agronomia / Energia na Agricultura) – Faculdade de Ciências Agronômicas, Universidade Estadual Paulista.
Author: THIAGO DO NASCIMENTO SANTANA DE ALMEIDA

SUMMARY
In this papper is evaluated the estimation of daily solar ultraviolet radiation (UV) using machine learning techniques in Botucatu / SP / Brazil. To develop the model was utilized the artificial neural networks with linear function, the support vector machine with linear function and with RBF function. As input to each of the techniques, were tested five groups containing different weather variables measured as routine in Botucatu radiometry solar station.

28 Ağustos 2013 Çarşamba

Prediction of the energy values of feedstuffs for broilers using meta-analysis and neural networks


Prediction of the energy values of feedstuffs for broilers using meta-analysis and neural networks
F. C. M. Q. Mariano,C. A. Paixão,R. R. Lima,R. R. Alvarenga,P. B. Rodrigues and G. A. J. Nascimento (2013).
animal, Volume 7, Issue09, September 2013 pp 1440-1445
http://journals.cambridge.org/action/displayAbstract?aid=8962130


Abstract

Several researchers have developed prediction equations to estimate the metabolisable energy (ME) of energetic and protein concentrate feedstuffs used in diets for broilers. The ME is estimated by considering CP, ether extract, ash and fibre contents. However, the results obtained using traditional regression analysis methods have been inconsistent and new techniques can be used to obtain better estimate of the feedstuffs’ energy value. The objective of this paper was to implement a multilayer perceptron network to estimate the nitrogen-corrected metabolisable energy (AMEn) values of the energetic and protein concentrate feeds, generally used by the poultry feed industry. The concentrate feeds were from plant origin. The dataset contains 568 experimental results, all from Brazil. This dataset was separated into two parts: one part with 454 data, which was used to train, and the other one with 114 data, which was used to evaluate the accuracy of each implemented network. The accuracy of the models was evaluated on the basis of their values of mean squared error, R 2, mean absolute deviation, mean absolute percentage error and bias. The 7-5-3-1 model presented the highest accuracy of prediction. It was developed an Excel® AMEn calculator by using the best model, which provides a rapid and efficient way to predict the AMEn values of concentrate feedstuffs for broilers.

FannTool;

 The software FANN TOOL 1.2 (http://code.google.com/p/fanntool/) was used to implement the networks.


29 Mart 2013 Cuma

Yacht Hydrodynamics

Yapay Sinir Ağlarının Gemi İnşa mühendisliği konusundaki bir uygulamasından bahsedeceğiz.

Yaz dizaynı için konun uzmanı olmadığımızdan  orjinal verilere atıfta bulunacağız

Data Set Information:

Prediction of residuary resistance of sailing yachts at the initial design stage is of a great value for evaluating the ship’s performance and for estimating the required propulsive power. Essential inputs include the basic hull dimensions and the boat velocity.

The Delft data set comprises 308 full-scale experiments, which were performed at the Delft Ship Hydromechanics Laboratory for that purpose.
These experiments include 22 different hull forms, derived from a parent form closely related to the ‘Standfast 43’ designed by Frans Maas.

Attribute Information:

Variations concern hull geometry coefficients and the Froude number:

1. Longitudinal position of the center of buoyancy, adimensional.
2. Prismatic coefficient, adimensional.
3. Length-displacement ratio, adimensional.
4. Beam-draught ratio, adimensional.
5. Length-beam ratio, adimensional.
6. Froude number, adimensional.

The measured variable is the residuary resistance per unit weight of displacement:

7. Residuary resistance per unit weight of displacement, adimensional. 

Veri setine UC Irvine Machine Learning Repository den Yacht Hydrodynamics adıyla ulaşabilirsiniz.

Veriler  Delft Teknik Üniversitesinin  Gemi Hidromekanik Labaratuvarındayapılan deneylerden alınmıştır. Bizim Çalışmamıza benzer bir çalışma da yapılmıştır

"Prediction of Total Resistance Coefficients Using Neural Networks"
 I.Ortigosa, R. López and J.García
Daha detaylı bilgi ve Çalışmaya ulaşmak için bakınız sayfa 15

Biz öncelikle Verileri FANNTool 'un DataProcessing kısmıyla açıp verileri normalize edip FANN formatına çevirdik. ilk 6 sütün giriş Son sütüun Çıkış değeri olarak  seçildi. Verilerin 184 adedi Eğitim ve 124 adedi Test için kullanıldı. Değişik konfigurasyonlarda Pek çok YSA eğitildi.
Ulaşılan sonuçları şöyle gösterelim


Bu sonuçlar Test verileri üzerinden çıkarılmıştır, Eğitim veri sonuçları daha da başarılıdır.


10 Mart 2013 Pazar

Baraj Yatay Deformasyon Modellenmesi


Barajlarının deformasyonların ölçülmesi ve modellenmesi, Güvenlik açısında önemlidir. Biz bu çalışmamızda Yapay Sinir Ağları ile bir modelleme yapacağız.

Veriler :

"Schlegeis barajı Avusturya’nın en önemli hidroelektrik santrallerinden biridir. Çift eğrilikli beton kemer şeklinde 1973 yılında hizmete giren baraj 131m yüksekliğinde ve kret uzunluğu 725m’dir.

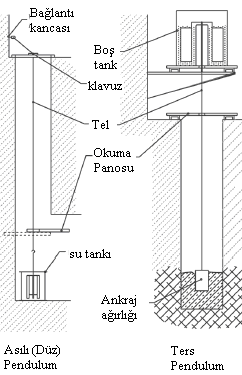
Asılı (Düz) ve ters pendulumlar kemer barajın düşey ekseni boyunca gövdenin bağıl yatay hareketlerini doğruluklu olarak belirlemek için yerleştirilen düzeneklerdir. 


Gövdenin oturduğu kaya zemine gömülen ters pendulum teli sayesinde gövdenin mutlak yatay hareketleri 0.5mm doğrulukla belirlenebilir.


Su kotu değerleri 9 yıllık dönem boyunca her gün sabah saat 09:00 da kaydedilen baraj gölü su düzeyi kayıtlarıdır. Hava sıcaklığı, 24 saatlik kayıtların günlük ortalama değerlerini gösterir. Analize konu olan pendulum değerleri ise, barajın en büyük düşey kesitinin yatay konum değişimleridir. Bu değişimler memba(su tarafı), mansap(gövdenin su olmayan tarafı) ile gövdenin dayandığı vadi yamaçlarına (sağ ve sol sahil) göre tanımlanır. Elektronik olarak kaydedilen bu değerler; kuzey (memba), güney (mansap), doğu (sağ sahil) ve batı  (sol sahil) yönleriyle ifade edilir."

 Veriler ve gereken bilgiler YTÜ meslek yüksek okulu öğretim üyesi ve Harita Y. Mühendisi Seyfullah Demirkaya 'dan alınmıştır

Modelleme

 Biz bu çalışmamızda deformasyon modellemesini Yapay Sinir Ağlarıyla yaptık, Öncelikle verilerin
YSA sistemine uygulanmasına bakalım

 Girişler :
W_LEVEL  : Su sevyesi metre
T_H12_UP, T_H12_MI, T_H12_DO , T_H15_UP , T_H15_MI,T_H15_DO   :
Beton sıcaklıkları
   UP  : Upstream: Memba (Baraj gövdesinin su tarafı)
   DO : Downstream: Mansap (Barajın hava olan tarafı)
   MI  : Mid: Gövdenin ortası 
T_AIR_M :  Hava Sıcaklığı
Çıkış :
PENDULUM : Ölçülen deformasyon ( mili metre )

Giriş ve çıkış değerleri kararlaştırıldıktan sonra, veriler üzerinde gereken normalizasyon işlemi yapılmış ve Eğitim ve Tes için veriler ikiye ayrılmıştır.

YSA kütüphanesi olarak FANN kullanılmıştır. YSA eğitimi FannTool ile  gerçekleştirilmiştir. İstendiğinde Eğitilmiş YSA ile Tahmin yapmak üzre program yazılabilir...


Sonuç:


Eğtim Verileri için Ortalama Mutlak Hata Yüzde :  %  2.4
Test Verileri için Ortalama Mutlak Hata Yüzde :     % 3,67


2 Mart 2013 Cumartesi

Yapay Sinir Ağları ile Epilepsi İçin Otomatik EEG analizi


Özet :

Bu çalışma Epileptik ve Normal EEG verilerinin , Yapay Sinir Ağları ile ve PoincarePlot2D metoduyla çıkarılan öznitelikleri kullanarak sınıflandırılması üzerinedir.

Giriş :


Epilepsi Dünya nufusunun %1'ni etkileyen bir rahatsızlıktır. Beynimiz milyarlarca sinir hücresinden oluşur ve bu hücreler üzerinde sürkeli bir elektiriksel iletişim vardır. Epilepside Beynin normalde çalışması ile ilgili elektriğin, aşırı ve kontrolsüz yayılımı sonucu oluşan ve herhangi bir uyarı olmaksızın tekrarlayan, çoğunlukla geçici bilinç kaybına neden olan bir hastalıktır.

EEG yani Elektroensefalografi beynin elektriksel aktivitesini ölçmek için kullanılan bir metoddur. Aynı zamanda epilepsili hastaları ve şüphe oluşturan nöbet bozuklukları olan hastaları incelemekte kullanılan önemli bir tetkiktir.

Uzun süreli EEG sinyallerinin incelenmesi ve istenen bilgilerin çıkarılması oldukça uzun zaman alan ve tecrübe gerektiren bir iştir. Bu yüzden  Otomatik EEG analiz sistemleri üzerinde çalışmalar yapılmaktadır. Bu çalışmada benzeri bir sistem üzerinedir.

Metod :

Pek çok Yapay Zeka uygulamasında olduğu gibi ilk aşamalardan biri Öznitelik Çıkarma işlemidir. Biz bu çalışmada PoicarePlot2D diye adlandırdığımız -deneysel- bir metodu uyguladık.

Poicare Plot  adını fransız matematikçi H. Poincare den alan bir metoddur.  Basitçe anlatırsak
X1, X2,... Xn 
şeklindeki bir zaman serisinin  2 boyutlu bir koordinat sisteminde  sırayla

 (X1, X2 ) ,   (X2, X3 ) ,  (X3, X4) , .... ,   (Xn-1, Xn )

noktalarının  çizilmesidir.

 Mesela Basit bir sinus serisinin

Poincare Grafiğine dönüşmüş hali

 Şeklinde görünür.

Öznitelik çıkarma işleminde veri seti ile Poincare Grafiği oluşturulur ve çıkan şeklinden yola çıkılarak 20x20 lik bir matris oluşturulur.


Sinus verisi için çıkarılan öznitelik matrisi bu şekildedir.

İkinci aşama ise çıkarılan özniteliklerin seçilecek bir Yapay zeka Algoritmasıyla sınıflandırılmasından ibarettir. Biz çalışmamızda Yapay Sinir Ağı metodunu kullandık. YSA için FANN kütüphanesini kullandık .  Eğitimi ve sonuçların testi içinde FannTool programından faydalandık.

Veri Seti :


Çalışmamızda kullandığımız ,  Bonn Üniversitesinde,  Epileptoloji Bölümünün hazırladığı  bir EEG veri setidir.  Verilere  bu adresden ulaşabilirsiniz. 
Bütün kayıtların alımı 128 kanallı kayıt sisteminde 12-bit A/D dönüstürücü ile yapılmıştır. Örnekleme frekansı 173.61 Hz dir. Band-geçiren filtre aralıgı ise 0.53–40 Hz (12 dB/octave) dir.
5 sınıfa ayrılmış veriler var ve her sınıfda 100 adet veri dosyası var her dosyada 4096 değer var.

  • Sınıf A  : Sağlıklı Gönüllülerden alınmış Göz Açık ( Z )
  • Sınıf B  : Sağlıklı Gönüllülerden alınmış Göz Kapalı ( O )
  • Sınıf C  :  Epilepsi hastası Kriz dışında Epileptik olmayan bölgeden  ( N )
  • Sınıf D  : Epilepsi hastası Kriz dışında Epileptik olan bölgeden  ( F )
  • Sınıf E  : Epilepsi hastası Kriz esnasında  ( S )

Uygulama :


Öncelikle  Veri setimizden

PoincarePlot2D metoduyla

Öznitelik çıkarma işlemini gerçekleştiriyoruz.


Bütün Sınıflandırma işlemini tek YSA ile yapmaya kalkıştığımızda Yaptığımız çeşitli denemeler sonucunda Test için ulaşabildiğimiz en yüksek başarı % 70 lerin biraz üstünde oluyor.

Bu yüzden bizde sınıflandırma işlemini parçalara ayırıyoruz ve her parça için ayrı YSA eğitiyoruz.
Bütün sınıflandırmayı 3 YSA ile gerçekleştiriyoruz

Birinci YSA ;  EEG verisi Sağlıklı birinden mi Epilepsi hastasından mı alınmış  kararını veriyor
500 veriden  375'ini eğitim ve 125'inide test için kullanıyoruz.

400 giriş 1 Çıkış

İkinci YSA ;  İlk YSA sonucunda Epilepsi Hastasından alınmış bir EEG ise, Verinin alınma konum ve yerine karar veriliyor.
  • Kriz sırasında, 
  • Kriz dışında, Epileptik taraftan 
  • Kriz dışında, Epileptik olmayan taraftan 

Kriz dışında 3 durum var. 300 veriden  225'ini eğitim ve 75'inide test için kullanıyoruz.


400 giriş 3 Çıkış

Üçüncü YSA ;  İlk YSA sonucunda Sağlıklı bireylerden alınmış bir EEG ise Göz Kapalımı, Açıkmı  kararını veriyor.  200 veriden  150'ini eğitim ve 50'inide test için kullanıyoruz.
 400 giriş 1 Çıkış  


Sonuç :

YSA ile yaptığımız bütün sınıflandırmalarda  ulaştığımız sonuç;
hem Eğitim hemde Test verileri için %100 başarı
Aynı veri seti kullanılarak yapılan  diğer çalışmaların başarıları aşağıdaki tabloda görülmektedir.


Yapılmış olan benzeri çalışmalar hakkındaki detaylı bilgiye
Automated Epileptic Seizure Detection Methods: A Review Study 
çalışmasından ulaşabilirsiniz yukardaki tabloda o çalışmadan alınmıştır.

13 Kasım 2012 Salı

Yapay Sinir Ağları ile Koroner Arter Hastalığı Risk Hesaplama


Kırıkkale Üniversitesi - Bilgisayar Mühendisliği Bölümü
Yapay Sinir Ağları Final Projesi
Sinem Özder

Bu çalışmada amaç, bir hastadan alınan input seti ile hastada 10 yıl içinde Koroner Arter hastalığı görülme olasılığının tahmin edilmesidir

Proje için şekildeki gibi bir YSA dizayn edilmiştir.
Giriş değerleri ;
• Cinsiyet
• Yaş
• LDL Kolesterol
• HDL Kolesterol
• Diyastolik Kan Basıncı
• Sistolik Basıncı
• Diyabet
• Sigara
Çıkış değeri;
• KAH Riski
Yazıyı İndirmek için ;  KAH-Risk 

FANN Kütüphanesinin Kullanımı


FANN yani Fast Artificial Neural Network Library Bir Yapay Sinir Ağı (YSA) Kütüphanesi.
YSA nın ne olduğunu bildiğinizi varsayıp. Basitçe kullanımını anlatmak istiyorum.
1) YSA oluşturulur
2) YSA Eğitilir
3) YSA Çalıştırılır.
4) YSA yı Tekrar Kullanama

1) Öncelikle Bir YSA oluşturmamız lazım
Kullanabileceğimiz Fonksiyonlardan biri fann_create_standard

struct fann *FANN_API fann_create_standard( unsigned int num_layers, ... )

YSA nın kaç katmandan oluştuğunu yazıp - num_layers -
Sırayla Giriş, Gizli Katman - yada Katmanlar - Çıkış Katmanlarının kaç birimden oluştuğunu yazıyoruz

Mesela :

5 giriş 2 çıkışlı Tek ve 7 birimlik Gizli Katmanlı bir YSA oluşturmak için

struct fann *ann = fann_create_standard(3, 5, 7, 2);

5 giriş 2 çıkışlı , 7 ve 3 birimlik olmak üzere 2 Gizli Katmanlı bir YSA oluşturmak için

struct fann *ann = fann_create_standard(4, 5, 7,3, 2);

ann işaretçisi artık bizim oluşturduğumuz YSA yı gösteriyor


2) YSA Eğitimi için Kullanabileceğimiz Fonksiyonlardan biri fann_train_on_file

void FANN_API fann_train_on_file(
struct fann * ann, // fann_create_standard ile almıştıkconst char * filename, // Veri Dosyaunsigned int max_epochs,unsigned int epochs_between_reports,
float desired_error
)
ann : fann_create_standard ile aldığımız bizim YSA mızı gösteren işaretçi
filename : Eğitim için kullanacağımız Veri Dosyasının adı
max_epochs : Eğitimin çalışacağı maksimum adım Sayısı
epochs_between_reports : Kaç Adımda bir Rapor verilmesi isteniyor
desired_error : Eğitim sonunda arzulanan hata miktarı

Bu fonksiyonu çağrılınca İsmini belirttiğimiz Dosyadan veriler alınır ve Hata miktarı istenen değere yada maksimum adım sayısına ulaşana kadar YSA eğitime tabi tutulur. Arada belirttiğimiz adımda rapor verilir. Eğer istenen hata değerine ulaşılamazsa eğitim başarısız olmuş olur.

Veri Dosyasının yapısı : Veri Dosyası dediğimiz şey Giriş ve çıkış değerlerinin bulunduğu basit bir text dosyasıdır.
Örnek Sayısı(N) Giriş(K) Çıkış (J)
G11 G12 G13 ...G1K
Ç11 Ç12 Ç13...Ç1J
G21 G22 G23 ...G2K
Ç21 Ç22 Ç23...Ç2J
....
GN1 GN2 GN3 ...GNK
ÇN1 ÇN2 ÇN3...ÇNJ

Mesela 3 Giriş 1 Çıkışlık 2 Örnekli bir veri dosyası

2 3 1
1 1 1
0
1 0 1
1

Eğitim öncesi Aktivasyon Fonksiyonlarını Ayarlamak istiyorsanız

fann_set_activation_function_hidden(
struct fann * ann,
enum fann_activationfunc_enum activation_function
)

fann_set_activation_function_output(
struct fann * ann,
enum fann_activationfunc_enum activation_function
)

Mesela
fann_set_activation_function_hidden(ann, FANN_SIGMOID);
fann_set_activation_function_output(ann, FANN_SIGMOID_SYMMETRIC);
gibi

Kendi rapor Fonksiyonumuzuda tanımlayabiliriz
void fann_set_callback( struct fann * ann, fann_callback_type callback )
Mesela 

int FANN_API my_report(struct fann *ann, struct fann_train_data *train,
unsigned int max_epochs, unsigned int epochs_between_reports,
float desired_error, unsigned int epochs)
{ 
printf("Adım %8d. MSE: %.5f. Desired-MSE: %.5f\n", epochs, fann_get_MSE(ann),desired_error);return 0;
 }

fann_set_callback( ann, my_report );


Eğer Dinamik bir eğitme süreci gerekmiyorsa, Eğitim ve Parametre ayarlarını kolayca FannTool ile yapabilirsiz

3) Artık Eğitimini tamamladığımız YSA yı çalıştırabiliriz. YSA'nın çalışması demek Giriş değerleri verilerek sonuçta elde edilen çıkış değerlerini almak demektir
Bu iş için kullanacağımız fonksiyon fann_run

fann_type * FANN_API fann_run( struct fann * ann, fann_type * input )

Yani YSA'yı giriş değerlerini içeren bir dizinin adresini gönderiyoruz.

Mesela 3 giriş 2 çıkışlı bir YSA için

fann_type *sonuc;
fann_type input[3]={1,1,0}; // giriş değerleri
sonuc = fann_run(ann, input);
printf("Çıkış Değerelri %f %f \n", sonuc[0], sonuc[1] );

4) YSA yı her kullandığımızda yukardekileri tekrar tekrar yapmamıza gerek yok. YSA eğitildikten sonra Kaydedip. Kullanacağımız zaman bu kayıttan yeniden YSA yı oluşturabiliriz.
Kaydetmek için fann_save Kullanımı çok basit

int fann_save( struct fann * ann, const char *FileName )

FileName kısmına bir Dosya ismi girip kaydediyoruz. Kayıt Geri dönüş değerine göre 0 ise başarılı -1 ise başarısız.

Kaydettiğimiz YSA yı tekrar yüklemek için fann_create_from_file fonksiyonu kullanılır.

struct fann * fann_create_from_file(const char *FileName)

Fonksiyon Kaydedilmiş Dosya ismiyle çağrılır.

Eğer YSA ile işimiz bittiyse fann_destroy kullanılarak hafızada YSA için kullandığımız alanlar boşaltılır.

void fann_destroy( struct fann * ann )

Mesela : YSA için İlk üç adımı yaptık kaydediyoruz

fann_save(ann, "YSA.net");
fann_destroy(ann);

Tekrar çağırıyoruz

fann_create_from_file("YSA.net");

 5) Test Etmek : Eğittiğimiz YSA yı test etmek gerekmektedir Eğitim için kullandığımız verinin % 10 - 30 arasındaki bir miktarda veriyle YSA test edilir ve Hata faktörüne bakılır. Öncelikle aynı Eğitim verisi için kullandığımız dosya yapısında bir dosya hazırlanır ve fann_read_train_from_file fonksiyonuyla yüklenir. Bundan sonra tek yapacağınız fann_test_data fonksiyonunu çağırmak. işi bitincede fann_destroy_train ile hafızdaki yerleri boşaltmak

Mesela :
struct fann_train_data *dt;
dt=fann_read_train_from_file("test.dat");
ann=fann_create_from_file("aproje.net");
fann_reset_MSE(ann);
fann_test_data(ann,dt);
printf("\n Test Sonucu MSE : %f \n\n", fann_get_MSE(ann) );
fann_destroy_train(dt);

MSE (Mean Square Error) dediğimiz şey ortalama karesel hata yani bizim YSA mız yaptığı - Eğitim yada Test - işte istenenle hesaplanan değerler arasındaki - Hata - farklarının karelerinin ortalaması gibi birşey

void fann_reset_MSE(struct fann *ann)
MSE değerini sıfırlar

float FANN_API fann_get_MSE(struct fann *ann)
MSE değerini okur


6) Diğer Faydalı Fonksiyonlar

Eğitim Algoritmalarını ayarlayanlar

enum fann_train_enum fann_get_training_algorithm(struct fann *ann)
Kullanılan Eğitim metodunu okur

void fann_set_training_algorithm(struct fann *ann,enum fann_train_enum training_algorithm)
* Eğitim metadunu değiştirir.

Eğitim metodları ise  
FANN_TRAIN_INCREMENTAL, 
FANN_TRAIN_BATCH, 
FANN_TRAIN_RPROP, 
FANN_TRAIN_QUICKPROP 
olarak 4 çeşittir. Metodların detayı için kitaplara yada google müracaat edilsin

* Öğrenme hızını ayarlayanlar


float fann_get_learning_rate(struct fann *ann)
kullanılan öğrenme hızını döndürür.

void fann_set_learning_rate(struct fann *ann, float learning_rate)
Öğrenme hızını ayarlar. Öğrenme hızı için geçerli Normal Değer 0.7
Bu fonkisyonları FANN_TRAIN_RPROP metodu için kullanamıyoruz

* Aktivasyon Fonksiyonlarını Ayarlayanlar
Daha önce geçmişti
Gizli katman için
fann_set_activation_function_hidden(
struct fann * ann,
enum fann_activationfunc_enum activation_function
)
Çıkış katamanı için
fann_set_activation_function_output(
struct fann * ann,
enum fann_activationfunc_enum activation_function
)

kullanılır
Aktivasyon fonksiyonlarıda ;  
FANN_LINEAR,
FANN_THRESHOLD,
FANN_THRESHOLD_SYMMETRIC,
FANN_SIGMOID, 
FANN_SIGMOID_STEPWISE, 
FANN_SIGMOID_SYMMETRIC, 
FANN_GAUSSIAN, 
 FANN_GAUSSIAN_SYMMETRIC, 
FANN_ELLIOT, 
FANN_ELLIOT_SYMMETRIC, 
FANN_LINEAR_PIECE, 
FANN_LINEAR_PIECE_SYMMETRIC 

gibi pek çok çeşit var detayı için bakınız


Uygulama 

 Güneş lekeleri

Güneş lekeleri , Güneş'in yüzeyinde (ışık yuvarda), çevresine oranla daha düşük sıcaklığa sahip olan, ve mıknatıssal etkinliğin gözlemlendiği bölgelerdir. Her ne kadar 4000-4500 K sıcaklık ile son derece parlak olsalar da, çevrelerinin 5778 K'de olması, karanlık bölgeler olarak görüldüklerinden bu ismi alırlar.
Neyse işte insanların işi gücü yok bu lekeleri sayıp kaydını tutmuşlar.Biz de bu verileri kullanacağız.

Öncelikle Neural networks for financial time series prediction isimli dosyaya bir göz atın. O yazıda detaylarıyla anlatıldığı gibi Verileri aldığımız haliyle kullanmayız, ön işlemeden geçirmeliyiz. ( 3.4 Design of ANNs in finance kısmı )

Güneş lekelerinin (2006 - 1980) aralığında aylık ortamalarını raw.dat isimli dosyaya her satır 1 değer olarak kaydedildi. Öncelikle verileri YSA da kullanabilmek için - Kullandığınız aktivasyon fonksiyonuna göre - (0 , 1) yada ( -1 , 1 ) değerleri arasına çekiyoruz Normalizasyon. Bir ay sonraki ortalama güneş lekesi sayısını bulmak için önceki 24 ayın değerleri kullanılıyor. 2 adet gizli katman kullanılıyor yani YSA mızın yapısı girişten çıkışa doğru
24 -> 16 -> 7 -> 1

şeklinde oluyor. Peki Bu değerleri Nasıl belirliyoruz ? derseniz Net bir cevabı yok.* Genellikle Giriş ve çıkış düğüm sayısı bellidir. Saklı katman yada katmanlardaki düğüm sayıları YSA nın eğitim performansına göre seçilir.

Programımız
LoadRawData("raw.dat");
Normalize();
WriteTrainData(24,1,"sunspot.dat");
Train();
Test();
Run();

dan ibaret
Açıklamalarına gelince
  • LoadRawData : Ham verileri ismi verilen - Veri dosyasında Her satır 1 veri içeriyor- text dosyasından okuyup data dizisine aktarıyor
  • Normalize : Diziye atılmış verileri -0.8 ile 0.8 arsına çekerek Normalize ediyor
  • WriteTrainData : Normalize edilmiş verileri alıp FANN kütüphanesinin kullanabileceği veri dosyası olarak kaydediyor
  • Train : YSA yı Eğitiyor.
  • Test : test.dat dosyasındaki verileri kullanarak Eğitilmiş YSA'yı test edip sonuçta ulaşılan Hatadeğerini bildiriyor
  • Run : Verilerimizden Rasgele 10 adedini kullanarak YSA çalıştırılıyor ve YSA nın hesapladığı ve gerçek değeri birlikte gösteriyor
Şimdi gelelim benim yapmadığım fakat aslında yapılması gereken şeylerden bazılarına

1) Veri sayısı yeterince büyük olması lazım
2) Bu veriler Eğitim, Test ve Kontrol için 3 parçaya ayrılıp her işlem için kendine ayrılan veri kulanılması lazım.


Sonuçta yazılan projeyi indirmek için : SunSpot

* bakınız NN_FAQ Bu YSA için yazılmış Sıkça Sorulan Soruları İndirmenizi ve incelemenizde tavsiye ediyorum FAQ.

10 Kasım 2012 Cumartesi

Diagnosis of Coronary Artery Disease Using ANN / YSA ile Koroner Arter Hastalığı Tanısı

Veri Setini University California Irvine nin ilgili sayfasından
http://archive.ics.uci.edu/ml/datasets/Heart+Disease
indirdik. Bu sayfadaki verilerden biz "Cleveland Clinic Foundation" tarafından oluşturulanları kullandık.
Bu syafada görebileceğiniz gibi bu verilerle pek çok çalışma yapılmıştır

Bizde YSA ile bir çalışma yapalım istedik.
YSA ya bir şeyler öğretebilmek için eğitim gerekli, Eğitim içinse veri.

Sınıflandırma yapmamız için etkili olan faktörler tespit edilir - Giriş değişkenleri -
Sonuçta bu faktörlere göre bir sınıflara ulaşırız -Çıkış değerleri - 
İşte Bu giriş ve çıkış değerleri YSA nın giriş ve çıkış değerleri oluyor.

Peki YSA verileri doğrudan verebilirmiyiz ?
Malesef veremeyiz.
YSA da katmanlar arasında veri iletişimi bir çeşit aktivasyon fonksiyonundan geçerek sağlanır. Bu fonksiyonlarda tipine göre (0 , - 1 ) yada (-1 , 1) aralığında sonuçlar verir. Bu durumda bizim verilerinizi bu aralıklara çekmemiz lazım.

Peki Bu normalizasyon işlemini nasıl yapacağız.
Değişkenin en küçük (min) ve en büyük (max) değerleri tespit edilir ve bir aralık hesaplanır
range = max-min
Biz bu uygulamamızda ( 0 - 1) aralığını kullandığımızdan normalizasyon formülümüz şöyle oluyor.
Norm(x)= (x-min)/range
ufak bir tavsiyede bulanayım değişkenin veri kümesinden tespit ettiğimiz min max değerlerini aralığı hafifçe açacak şekilde genişletirseniz daha iyi olur.

Giriş değişkeni eğer mantıksal bir değişkense, (doğru-yanlış) gibi sadece iki değeri içeriyorsa normalizasyonu gayet kolay değerin biri 0 diğeri 1 olarak seçilir.

Peki değişken eğer sayısal değilse ne yapacağız mesela bizim örneğimizde "chest pain type"
göğüs ağrısı tipi diye bir değişken var ve bu değişken {angina, abnang, notang, asympt} gibi 4
değişik kategoriden oluşuyor. Bu durumda yapacağımız şey bu tip değişkenleri mantıksal değişkenlere bölmek
yani chest pain type değişkenini 4 adet mantıksal alana yayıyoruz
eğer ağrı tipi
angina ise 1 0 0 0 
yok 
notang ise 0 0 1 0 gibi.
Şimdi gelelim verilerimize verilerin aslı aşağıdaki gibi bir matriste tutuluyor

60, male, asympt, 140, 293, fal, hyp, 170, fal, 1.2, flat, 2, rev, sick.
37, male, notang, 130, 250, fal, norm, 187, fal, 3.5, down, 0, norm, buff.
64, male, angina, 110, 211, fal, hyp, 144, true, 1.8, flat, 0, norm, buff.

bu matriste 14 sütün var ilk 13 ü giriş değişkenleri son sütün çıkış değişkeni. fakat biz bu
değişkenleri YSA ya aktarabilmek için normalize ederken sütün sayımız 25 e çıkıyor nasıl mı oluyor bakınız


ANN Dizaynı

| Inputs
| ------------------------
| -- 1. age : 1 sütun
| -- 2. sex : 1 sütun
| -- 3. chest pain type (4 values) : 4 sütun
| -- 4. resting blood pressure : 1 sütun
| -- 5. serum cholestoral in mg/dl : 1 sütun
| -- 6. fasting blood sugar > 120 mg/dl : 1 sütun
| -- 7. resting electrocardiographic results (values 0,1,2) : 3 sütun
| -- 8. maximum heart rate achieved : 1 sütun
| -- 9. exercise induced angina : 1 sütun
| -- 10. oldpeak = ST depression induced by exercise relative to rest : 1 sütun
| -- 11. the slope of the peak exercise ST segment : 3 sütun
| -- 12. number of major vessels (0-3) colored by flourosopy : 4 sütun
| -- 13. thal: ( normal, fixed defect,reversable defect) : 3 sütun
25 giriş

| Outputs
| ------------------------
| Absence (1) or presence (2) of heart disease 1 sütun

1 Çıkış

evet Elimizdeki 180 adet veriyi  normalize ettiktten sonra ikiye ayırıyoruz.
155 adedi eğitim için 25 adedi test için. ve verileri FANN kütüphanesinin standartına uygun olarak kaydediyoruz.

Bundan sonrasını FannTool'u kullanarak yapacağız. FannTool'u çalıştırın ve Eğitim için Training
Data File olaraka "heart_train_data.dat" yükleyin, Test içinde  "heart_test_data.dat" 'ı yükleyin.

Artık Keyfinize ve tecrübelerinize göre eğitim denemelerinini yapabilrsiniz.

ilk etapta saklı katman sayısı (# of Layer)
ve bu katmanlardaki hücre sayılarını (Hid Layer 1 ...) ayarlaya bilirsiniz.
İsterseniz Eğitim metodunu (Detect Optimum Training Algorithm)
ve Aktivasyon foksiyonlarını (Detect Optimum Activation Functions )
sizin için seçmesini istiyebilirsiniz.
Ezberci bir eğitime düşmemek için   ( Overtraining Caution System ) seçeneğini açıp eğitim esnasında test verilerinin hata durumlarını takip edebilirsiniz.
Artık Train -> Normal diyerek YSA eğitimini başlata bilirsiniz. Eğer Belirlediğiniz hata değerine yada altına ulaşıldığında Eğitilmiş YSA yı kaydetmek için sizden bir dosya ismi istenir. Bir isim verip kaydedin .net uzantılı olarak kaydetmeniniz iyi olur.

Eğitimin bir diğer metoduda Train->Cascade dir bu metodda YSA nın Saklı katmanlarını kendisi dinamik olarak belirler. Siz sadece kullanabileceği maksimum hücre sayısını belirtebilirsiniz. Bu değeri de FannTool Saklı katmanlardaki hücre sayılarını giriş ve çıkış hücre sayılarına ekleyerek hesaplar.
Ulaştığımız sonuçlar şöyle

Eğitim verileri İçin % 91.61  ( 142 Doğru 13 Yanlış )
Test Verileri İçin % 92 ( 23 Doğru 2 Yanlış )

 Eğitimizi tamamlayıp testimizi yaptık ve sonucunda tatminkar hata değerine ulaştık. Bütün bunlardan sonrayapılacak şey  bir arabirim yazmaktır. 
Onuda yazdık, İndirmek ( Download ) için : Hearth
Program Tanı için gereken verileri alıp Eğitilmiş YSA ya verileri verip sonucu ondan istiyor ve size gösteriyor. yani kısaca  Koroner Arter Hastalığı Tanısı işlemini gerçekleştiriyor.

6 Kasım 2012 Salı

FANN – neural networks made easy

Author : Swizec
Source : FANN – neural networks made easy

Over the weekend I was struck with the realization that I don’t know how to use neural networks in practice, damn it. Even though a few months ago I realized what neural networks are, even though I’ve tried implementing them, even though I’ve used them in a class setting …
How the hell do you use these things in real life!?
Implement from scratch? … no that can’t be it.
Find a library, write some code, run some tests, fiddle with features, run a test, fiddle with features, realize everything is slow, decide to use more layers, fiddle with features, play around with activation functions, run a test, fiddle with features, rewrite the code because it’s a mess, fiddle with features, run a test, run the network, run more tests and so on and on ad nauseum.
That can’t be it either …

FANN

Looking far and wide for a good library to use I stumbled upon FANN – Fast Artificial Neural Networks.
Fast Artificial Neural Network Library is a free open source neural network library, which implements multilayer artificial neural networks in C with support for both fully connected and sparsely connected networks. Cross-platform execution in both fixed and floating point are supported. It includes a framework for easy handling of training data sets. It is easy to use, versatile, well documented, and fast. Bindings to more than 15 programming languages are available. An easy to read introduction article and a reference manual accompanies the library with examples and recommendations on how to use the library. Several graphical user interfaces are also available for the library.
Perfect!
Not only has someone gone to the trouble of implementing everything and making sure it works – nothing sucks more than figuring out whether you’re using your learning software wrong or it’s just buggy – they even gave it all the fiddly features I need!
It gets better! There’s a slew of graphical interfaces -> You get to play with the fiddly bits without even knowing what you’re doing! Yes!
Put the data in the fann format, load it up, and away you go. Playing around until you figure out what you’re looking for, then you can just implement the same thing with the FANN binding of your choice.


It can suggest a good training algo


You get to set up the neural network


Fiddly bits!


Watch it converge in real time

Done in a few hours

FANN really saved my skin last night. At least the GUI did. I still haven’t solved my problem – trying to predict how many people will read a whole post – but it took me literally a couple of minutes to realize that the same network can’t be used to predict two outputs since it won’t even converge.
That’s something very specific to the problem.
I also realized the networks were overfitting my data, then performing poorly on the test.
Another specific thing.
It is because of this incredibly problem-specific nature of most work involving neural networks that having tools like these is really important. Who wants to fiddle around with implementing all this stuff by hand for several hours before even running the first tests?
I probably ran twenty or thirty different configurations in the space of three hours last night. Could I have done that without a simple tool? Probably not – wouldn’t even have the first configuration implemented by now.
Now if only the GUI tool calculated precision and recall instead of mean standard error …

5 Kasım 2012 Pazartesi

Rapport de Projet VidéoBuzz

 Rapport de Projet Master -Université d'Avignon

Description

Les sites d'hébergement de vidéos déposées par les utilisateurs ont connu un très fort développement ces dernières années. Certaines de ces vidéos ont été consulté par des milliers d'internautes, d'autres restent archivées sans qu'elles soient significativement visionnées. Ce projet consiste à développer un système de prédiction de la fréquentation à court terme d'une vidéo. Cette prédiction pourra utiliser 2 indices complémentaires :
- à partir d'un historique de la fréquentation d'une sur une période donnée (par exemple de 2 jours), on pourra utiliser un système prédictif (par exemple un réseau de neurones) pour faire une estimation de la fréquentation future,
- les utilisateurs ajoutent souvent des méta-données (des tags) aux vidéos déposées. Ces informations et le titre de la vidéo peuvent donner une indication sur le buzz potentiellement généré par une vidéo.

Outre les propositions de méthodes et leur évaluation objectives, le projet consiste à développer une application Web permettant de visualiser les prédictions réalisées.

Fanntool ; 


FannTool est un logiciel multi-plateforme développé en C qui fournit un ensemble d’outils permettant l’utilisation de la librairie FANN. FANN ( pour Fast Artificial Neural Network ) est une librairie open-source de réseaux de neurones qui permet à la fois l'entraînement du réseau neuronal et ensuite l’utilisation de celui-ci.
Il faut lui fournir en entrer un fichier respectant ce format:

3 Kasım 2012 Cumartesi

Handwritten Digit Recognition

Handwritten digits recognition is a classic problem of machine learning. The objective is to recognize images of single handwritten digits(0- 9). in This example We will apply FANN and FANNTool on this problem. Semeion Handwritten Digit Data Set is used for training and testing.

1593 handwritten digits from around 80 persons were scanned, stretched in a rectangular box 16x16 in a gray scale of 256 values.Then each pixel of each image was scaled into a boolean (1/0) value using a fixed threshold. This data set contains no missing values. Each person wrote on a paper all the
digits from 0 to 9, twice. The commitment was to write the digit the first time in the normal way


and the second time in a fast way


This data set consists of 1593 records (rows) and 256 attributes (columns). Each record represents a handwritten digit, originally scanned with a resolution of 256 grays scale. Each pixel of the each original scanned image was first stretched, and after scaled between 0 and 1 (setting to 0 every pixel
whose value was under the value 127 of the grey scale (127 included) and setting to 1 each pixel whose original value in the grey scale was over 127). Finally, each binary image was scaled again into a 16x16 square box (the final 256 binary attributes).

 Firstly We train a ANN for this Data set by using FannTool. After that we write a demonstration program to show a results.

Reached ANN prediction Succes ;
For Training Data : %100 Succes
For Testing Data   :  % 90.1 Succes

31 Ekim 2012 Çarşamba

Yapay Sinir Ağları ile Ses Tanıma

Ses Tanıma genel olarak  üç aşamadan oluşuyor.
1) Ön işleme
2) Öznitelik Çıkarma
3) Tanıma ( YSA ile)
Deneysel olarak yapılan  bu çalışmada  RASTA-PLP, MFCC ve LP yöntemleri gerçekleştirildi Bu yazıda akustik vektörlerin MFCC (mel frequency cepstral coefficients) yöntemiyle oluşturulması anlatılıyor. ( deatylı bilgi için YSA ile Ses Tanıma )

Küçük bir veri seti hazırlandı 6 değişik kelime 10 kez seslendirildi. Bu ses dosyalarına yukardaki yazıda belirtilen metodlar uygulanarak öznitelik çıkarma işi yapıldı. Çıkarılan bu özniteliklerin 48 tanesini eğitim 12 tanesini test için kullandık.

    Giriş : 360
    Çıkış : 6

şeklinde bir YSA tasarlandı ve FannTool ile eğitildi, Ulaştığımız sonuçlar

    Eğitim Verisi : %100
    Test Verisi     : % 91

Pedestrian Detection

FYP - Pedestrian Detection Local Binary Pattern with HOG trained with ANN (FANN & FANNTool). Written in C using OpenCV. Now with rolling average of the last 5 frames. 4x Speed. Intensity of green represents probabilistic measurement of a cell containing a person. There's still some false positives and false negatives but should be fixable with larger training set and better MSE.

30 Ekim 2012 Salı

Forecasting the ozone concentrations


Forecasting the ozone concentrations with WRF and artificial neural network based system

Department of Climatology and Atmosphere Protection
Wrocław University, Poland

Introduction;

Ground level ozone (O3 ) has serious adverse impacts on human health and ecosystems. Accurate tools that support human and ecosystem protection are necessary. The most often used are complex atmospheric chemistry models (Vieno et al. 2010), driven by off-line meteorology or integrated on-line to allow for two directional effects of atmospheric chemistry and meteorology. These tools need a significant amount of computational effort, but are able to provide information on spatial and
temporal information on atmospheric ozone concentrations. Statistical methods, including regression models and artificial neural networks (ANN) are also often applied to provide information on spatial (Pfeiffer et al. 2009) and temporal variability of O . ANN were also found to be useful for O 3 3
forecasting, and were applied to e.g. metropolitan areas by local environmental or health agencies (Comrie 1997, Corani 2005, Ibarra-Berastegi et al. 2008, Yi and Prybutok 1996). In this paper we present the preliminary results of the O3 forecasting system for the city of Wrocław, SW Poland. Two main tools are used to estimate the hourly O3 for the next 3 and 24 hours – the Weather Research and Forecasting (WRF) mesoscale meteorological model and an artificial neural network (ANN). WRF provides the meteorological variables for the next 3 and 24 hours, and the ANN is then applied to forecast the O3 concentrations.

FannTool ;


...
 The analysis was performed with
the Fast Artificial Neural Network library and FANN Tool 1.1 interface.
...


27 Ekim 2012 Cumartesi

Automated Analysis of Cardiotocograms


Orjinal Çalışma ;
Özeti ;

To describe the latest version of SisPorto, a program for automated analysis of cardiotocograms that closely follows the FIGO guidelines, analyses ante- and intrapartum tracings, performs no signal reduction, and has the possibility of simultaneously recording twins.A detailed description of the program's processing algorithms and operation is provided, as well as the main results of the studies performed to-date with this system.Considering both current and previous versions of the program, SisPorto has been tested in over 6000 pregnancies. The system's FHR baseline was compared with an average of three experts' estimates, and the difference was under 8 bpm in all cases. A fair to good agreement was found with experts' identification of accelerations, decelerations, contractions, and normal/reduced variability (proportions of agreement 0.64-0.89). In a preliminary validity study (n = 85), a sensitivity of 100% and a specificity of 99% were obtained in prediction of poor neonatal outcome. The system is currently undergoing an international multicentre validation study.Although still at the research level, a considerable experience has now been gathered with this system. Promising results have been achieved in studies comparing SisPorto with experts' analysis and in those evaluating the validity of the system.

Çalışmanın verilerine The UCI Machine Learning Repository den Cardiotocography Data Set  başlığından ulaşabilirsiniz. Cardiotocography Anne karnındaki bebeğin kalp sağlığının belirlenmesi için kullanınal bir teknoloji. Sisporto ise Omniview-SisPorto adıyla ticarileşmiş bir proje artık.


Verilerin detayına bakacak olursak;
2126 fetal cardiotocograms (CTGs) were automatically processed and the respective diagnostic features measured. The CTGs were also classified by three expert obstetricians and a consensus classification label assigned to each of them. Classification was both with respect to a morphologic pattern (A, B, C. ...) and to a fetal state (N, S, P). Therefore the dataset can be used either for 10-class or 3-class experiments.

Attribute Information:


LB - FHR baseline (beats per minute)

AC - # of accelerations per second
FM - # of fetal movements per second
UC - # of uterine contractions per second
DL - # of light decelerations per second
DS - # of severe decelerations per second
DP - # of prolongued decelerations per second
ASTV - percentage of time with abnormal short term variability
MSTV - mean value of short term variability
ALTV - percentage of time with abnormal long term variability
MLTV - mean value of long term variability
Width - width of FHR histogram
Min - minimum of FHR histogram
Max - Maximum of FHR histogram
Nmax - # of histogram peaks
Nzeros - # of histogram zeros
Mode - histogram mode
Mean - histogram mean
Median - histogram median
Variance - histogram variance
Tendency - histogram tendency
CLASS - FHR pattern class code (1 to 10)
NSP - fetal state class code (N=normal; S=suspect; P=pathologic)
 Orjinal verinin 2 çeşit çıktısı var. İlkinde 10 çeşit FHR tipinden hangisi olduğu, ikincisinde ise üç çeşit Fetal State için (N=normal; S=suspect; P=pathologic) bir sınıflandırma var. Biz Örneğimiz için ikincisini kullandık.
Bütün YSA işlemleri FannTool ile yapıldı. Bir Önceki örneğimizdeki gibi program yazmadık sonuçalrı Excell Dosyasındaki "Full Sonuç-Eğitim" ve "Full Sonuç-Test" sayfalarında görebilirsiniz

Eğitim Verileri için Başarı Oranı :  % 98,72  (  1488 Örnekden  1469 Doğru )
Test Verileri için  Başarı Oranı   :  % 94.2  ( 638 Örnekden 601 Doğru  )
Dosyalar İndirmek İçin :  CTG.zip

26 Ekim 2012 Cuma

Yapay Sinir Ağları ile Finansal Başarısızlık Öngörüsü

Finansal Başarısızlık Öngörüsü hem Firmanın yöneticileri, Hem ilgili firmayla ilişkileri olan firmalar, hemde  - borsada olsun olmasın  - yatırımcıları  için önemli bir konudur.
Öngörü sonuçlarına göre Yöneticiler tedbirler alabilir, İlişkide oldukları firmalar için alternatifler arayabilir,  Yatırımcılar yatrımlarını daha güvenilir yerlere kaydırabilirler. Elbette İş işden geçmeden önce...

Ufak bir internet aramasıyla sizinde göreceğniz gibi pek çok değişik metod ve sistemle "Finansal Başarısızlık Öngörü"  çalışmaları yapılmıştır. Bizim Çalışmamızda Borsada işlem gören bazı şirketler için Yapay Sinir Ağları ile benzeri bir çalışma yapılmıştır.

Firmaların Son Üç yıllık
  • İşletme Sermayesi /Toplam Varlıklar
  • Net Kar/Toplam Varlıklar
  • FVÖK (Faaliyet Karı)/Toplam Varlıklar
  • Borçların Defter Değeri/Toplam Varlıklar
  • Satışlar/Toplam Varlıklar
  • FVÖK (Faaliyet Karı)/Toplam Faiz Ödemeleri

verileri kullanılarak  mevcut  yıldaki Finansal Başarı / Başarısızlıkları öngörülmeye çalışılmıştır.

Ulaşılan Sonuçlar : Doğru sınıflandırma başarı Yüzdesi olarak

Eğitim Verileri  : % 93,3
Test Verileri      : % 84.6
Resimden de göreceğiniz gibi Bütün çalışmada yine FannTool kullanıldı.

Yapay Sinir Ağları ile Tel Erozyon Hesabı


Tel Erozyon Nedir ;

İletken olan malzemelerin işlenmesi ve kesilmesi için kullanılan bir metod ve bu iş için kullanılan tezgahın adıdır. Malzeme Dielektirik bir sıvı içerisine daldırılır. Malzemenin  yüzeyi ile elektrod ( tel ) arasında ark oluşturularak  yüzey aşındırılırlır.

Bizim Çalışmamıza esas olan; Nihat Tosun'un  "Tel erozyon tezgahında tel aşınmasının ve yüzey pürüzlülüğünün deneysel olarak incelenmesi ve modellenmesi" başlıklı doktora tezidir. Bu tezde bir dizi deney yapılmış ve deney sonuçları Regresyon analiziyle modellenmiştir.
Biz bu deney datalarını FannTool ile YSA kullanarak modelledik.

Giriş Değerleri ( Kontrol Parametreleri ) olarak
; Puls Süresi, Gerilim, Tel İlerleme Hızı, Dielektirik Sıvı püskürtme basıncı kullanıldı.
Çıkış Değerleri ; Yüzey Prürüzlülüğü, Telde oluşan krater Derinlik ve Çapı , Ağırlık Kaybı

Parametrelerle ilgili detaylar için ilgili teze bakınız. Deneysel verilerin bir kısmı YSA eğitimi için kullanıldı. Kalan kısmıda Eğitilmiş YSA'nın performansını görmek için Test aşamasında kullanıldı.
Biz buraya Sadece Test Verireliyle ulaşılan Grafiklerden birkaç tane koyuyoruz.

Krater Derinliği Test Sonuçları :


Yüzey Pürüzlülüğü Test Sonuçları :